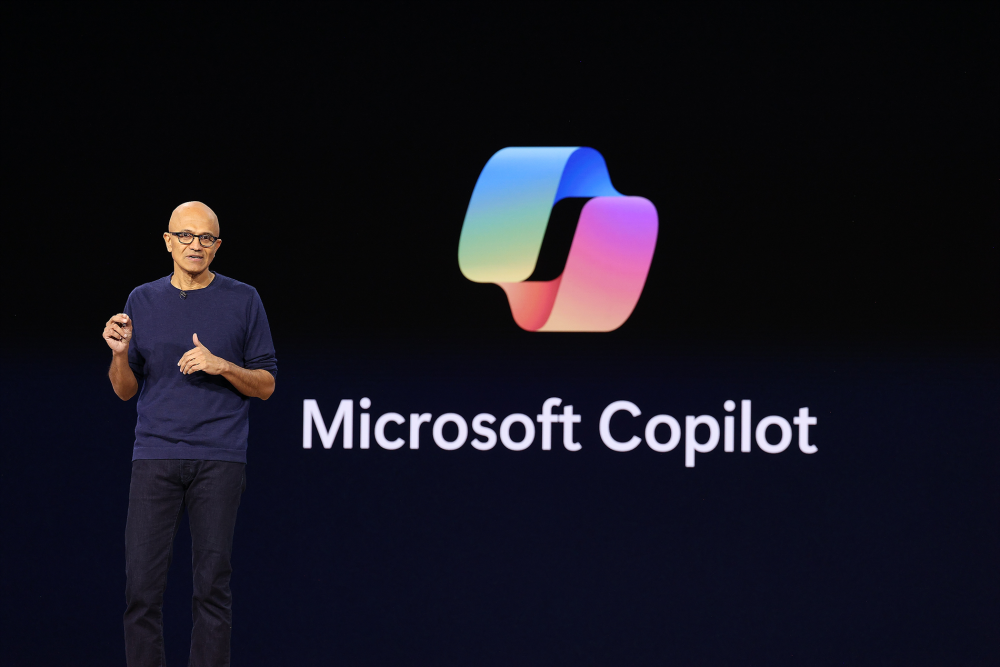
ساتیا نادلا، مدیرعامل مایکروسافت، معتقد است برای اینکه انسانها کنترل کامل هوش مصنوعی را در دست داشته باشند، باید معماری اعتماد در این سیستمها بازنگری شود. پیچیدگی مدلهای زبانی حالا به حدی رسیده که حتی متخصصان هم در تحلیل رفتارهای آنها به مشکل میخورند و همین موضوع، نیاز به لایههای حفاظتی بیرونی را ضروری کرده است.
معماری اعتماد و جعبههای سیاه تو در تو
نادلا صبح شنبه در شبکه اجتماعی X هشدار داد که نباید پاسخها یا توصیههای Super Intelligence را کورکورانه پذیرفت. او سیستمهای فعلی را به جعبههای سیاه تو در تو تشبیه میکند که در چنین ساختاری، درک منطق تصمیمگیری مدل بسیار دشوار است.
ترمز اضطراری و ساختار هدایتکننده
راهکار پیشنهادی مدیرعامل مایکروسافت، جداسازی مدل از ساختار هدایتکننده است. او میگوید کنترلهای حفاظتی باید به لایههای خارج از مدل منتقل شوند.
طبق این طرح، تمام اقدامات مهم مدل باید در مستنداتی ثبت شود که هم برای انسان قابل خواندن باشد و هم نتوان آنها را دستکاری کرد. نادلا تاکید دارد سیستمها باید بهگونهای طراحی شوند که هر فرد مجاز بتواند در هر لحظه، اجرای مدل را متوقف یا آن را کاملاً خاموش کند.
باید پیشفرض ما این باشد که مدل ممکن است آسیبپذیر باشد و از همان ابتدا آن را مهار کنیم؛ درست مانند یک ترمز اضطراری.
این دیدگاه با رویکرد محتاطانه داریو آمودی، مدیرعامل Anthropic، همسو است. هر دو مدیر ارشد صنعت تکنولوژی بر لزوم ایجاد لایههای ایمنی سختگیرانهتر تاکید میکنند تا از خروج مدلها از کنترل جلوگیری شود.
چنین رویکرد امنیتی در دنیای ابزارهای دیجیتال، شبیه به استراتژیهای پیچیده در زیرساختهای ارتباطی است؛ همانطور که در تلاشهای اسپیساکس برای تبدیل شدن به یک اپراتور موبایل، دقت در لایههای سختافزاری و نرمافزاری حرف اول را میزند.
تغییر تمرکز از بهبود عملکرد صرف به سمت ساخت سیستمهای کنترلپذیر، جلوی حوادث پیشبینینشده در سیستمهای خودمختار را میگیرد. اگر مدلها را به عنوان جعبههای سیاه بپذیریم، هر خطای سیستمی بدون امکان توقف سریع، میتواند پیامدهای گستردهای به دنبال داشته باشد.
سؤالات متداول
منظور ساتیا نادلا از معماری اعتماد در هوش مصنوعی چیست؟
او میخواهد ساختاری ایجاد شود که نظارت بر مدل AI و ایمنی آن، به جای تکیه بر خود مدل، در لایههای بیرونی و توسط انسانها مدیریت شود.
ترمز اضطراری در سیستمهای AI چه کاربردی دارد؟
این مکانیسم اجازه میدهد کاربر یا ناظر مجاز، در صورت مشاهده رفتارهای غیرعادی یا خطرناک، اجرای مدل را فوراً متوقف یا سیستم را خاموش کند.
تفاوت مدل و ساختار هدایتکننده از نظر نادلا چیست؟
از نظر او مدل باید از ابزارهای کنترلی (Harness) جدا باشد. این جداسازی باعث میشود لایههای حفاظتی و نظارتی بدون دستکاری در هسته مدل، بهطور مستقل مدیریت شوند.